이 글의 목차
프로덕션에서 터진 검색 장애
금요일 오후 5시, 퇴근 직전에 슬랙 알림이 울렸다.
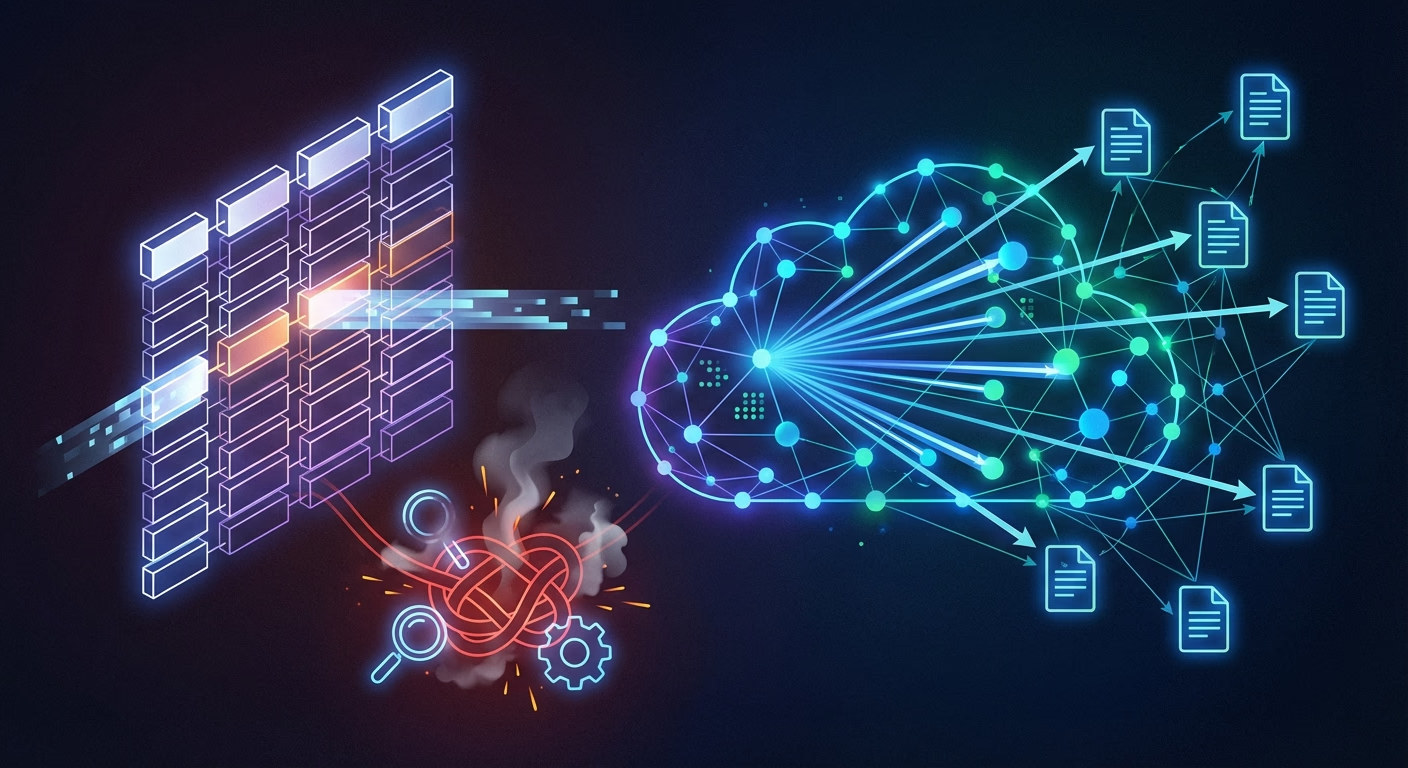
🚨 [ALERT] Database CPU 95% - Product Search APIResponse Time: 12,000ms (threshold: 500ms)Error Rate: 45%이커머스 서비스의 상품 검색이 완전히 멈춰버렸다. 원인은 단순했다. 블랙 프라이데이 프로모션으로 트래픽이 3배 증가했는데, 상품 검색이 MySQL의 LIKE '%keyword%' 쿼리로 동작하고 있었던 것이다.
-- 문제의 쿼리SELECT * FROM productsWHERE name LIKE '%블루투스 이어폰%' OR description LIKE '%블루투스 이어폰%'ORDER BY created_at DESCLIMIT 20;200만 개의 상품 데이터에서 이 쿼리는 Full Table Scan을 수행했고, 동시 접속자 수가 늘어나자 데이터베이스가 버티지 못했다.
이 글에서는 왜 RDBMS의 LIKE 검색이 프로덕션에서 문제가 되는지, 전문 검색 엔진이 이를 어떻게 해결하는지, 그리고 Elasticsearch의 핵심 개념을 알아본다.
RDBMS LIKE 검색의 한계
왜 LIKE ‘%keyword%‘는 느린가?
일반적인 B-Tree 인덱스는 왼쪽부터 시작하는 검색에만 효과적이다.
-- 인덱스 사용 가능 (Left-anchored)SELECT * FROM products WHERE name LIKE '블루투스%';
-- 인덱스 사용 불가 (Full Table Scan)SELECT * FROM products WHERE name LIKE '%블루투스%';%가 앞에 붙는 순간, 데이터베이스는 모든 행을 하나씩 확인해야 한다. 100만 행이면 100만 번의 문자열 비교가 발생한다.
실제 성능 비교
MySQL 8.0에서 100만 개 상품 데이터로 테스트한 결과:
| 쿼리 패턴 | 실행 시간 | 인덱스 사용 |
|---|---|---|
LIKE 'keyword%' | 15ms | ✅ B-Tree Index |
LIKE '%keyword%' | 2,800ms | ❌ Full Table Scan |
LIKE '%key%word%' | 3,200ms | ❌ Full Table Scan |
동시 요청이 100개만 되어도 데이터베이스 커넥션 풀이 고갈된다.
Full-Text Index의 한계
MySQL과 PostgreSQL은 Full-Text Index를 지원하지만 한계가 있다:
-- MySQL Full-Text SearchALTER TABLE products ADD FULLTEXT INDEX ft_idx (name, description);
SELECT * FROM productsWHERE MATCH(name, description) AGAINST('블루투스 이어폰' IN NATURAL LANGUAGE MODE);
문제점:
- 한국어 지원 미흡: 기본 파서가 공백 기준으로만 토큰화
- 실시간 업데이트 부담: 대량 INSERT/UPDATE 시 인덱스 재구축 오버헤드
- 고급 기능 부재: 형태소 분석, 동의어 처리, 자동완성 등 미지원
- 분산 확장 불가: 단일 서버의 물리적 한계
검색 엔진이 필요한 순간
다음 요구사항 중 하나라도 해당되면 전문 검색 엔진을 고려해야 한다:
- 대량 텍스트 검색: 수십만 건 이상의 텍스트 데이터에서 키워드 검색
- 한국어 검색: 형태소 분석이 필요한 언어
- 자동완성: 입력 중 실시간 검색어 제안
- 오타 허용: “블루투쓰” → “블루투스” 매칭
- 관련성 랭킹: 단순 일치가 아닌 관련도 순 정렬
- 확장성: 데이터 증가에 따른 수평 확장 필요
역인덱스(Inverted Index)란?
Elasticsearch의 핵심은 역인덱스다. 일반적인 인덱스가 “문서 → 단어”를 매핑한다면, 역인덱스는 “단어 → 문서”를 매핑한다.
책의 색인과 같은 원리
책 뒤에 있는 색인(Index)을 생각해보자:
책의 색인:- Elasticsearch ... 12, 45, 89, 102- 검색 ............ 15, 23, 67, 89- 인덱스 .......... 45, 78, 102“Elasticsearch”를 찾고 싶으면 색인에서 해당 단어를 찾고, 페이지 번호(12, 45, 89, 102)로 바로 이동한다. 책 전체를 읽을 필요가 없다.
역인덱스 구조
다음 세 개의 문서가 있다고 가정하자:
| Doc ID | 내용 |
|---|---|
| 1 | 블루투스 이어폰 추천 |
| 2 | 무선 이어폰 리뷰 |
| 3 | 블루투스 스피커 추천 |
Elasticsearch는 이를 다음과 같이 역인덱스로 저장한다:
역인덱스:┌─────────────┬────────────────┐│ Term │ Document IDs │├─────────────┼────────────────┤│ 블루투스 │ [1, 3] ││ 이어폰 │ [1, 2] ││ 추천 │ [1, 3] ││ 무선 │ [2] ││ 리뷰 │ [2] ││ 스피커 │ [3] │└─────────────┴────────────────┘“블루투스 이어폰”을 검색하면:
- “블루투스” → [1, 3]
- “이어폰” → [1, 2]
- 교집합: [1] → 문서 1이 가장 관련성 높음
시간 복잡도: O(1) - 문서 수에 관계없이 상수 시간에 검색 가능
Elasticsearch란?
Elasticsearch는 Apache Lucene 기반의 분산형 RESTful 검색 엔진이다.
핵심 특징
| 특징 | 설명 |
|---|---|
| 분산 아키텍처 | 데이터를 여러 노드에 분산 저장, 수평 확장 가능 |
| 실시간 검색 | 문서 색인 후 거의 즉시(~1초) 검색 가능 |
| RESTful API | HTTP/JSON 기반으로 모든 언어에서 쉽게 사용 |
| 스키마리스 | 유연한 JSON 문서 저장 (동적 매핑) |
| 풍부한 쿼리 | Full-text, 구조화된 쿼리, 집계, 지리정보 등 |
| 고가용성 | 복제본(Replica)으로 장애 대응 |
첫 번째 쿼리 실행해보기
Elasticsearch가 실행 중이라면, 다음 명령어로 상품을 색인하고 검색할 수 있다:
# 상품 문서 색인curl -X POST "localhost:9200/products/_doc/1" -H "Content-Type: application/json" -d'{  "name": "소니 WH-1000XM5 블루투스 헤드폰",  "description": "업계 최고의 노이즈 캔슬링 무선 헤드폰",  "price": 429000,  "category": "헤드폰"}'
# 검색curl -X GET "localhost:9200/products/_search" -H "Content-Type: application/json" -d'{  "query": {    "match": {      "name": "블루투스 헤드폰"    }  }}'
응답 예시:
{ "took": 5, "hits": { "total": { "value": 1 }, "hits": [ { "_id": "1", "_score": 1.2345, "_source": { "name": "소니 WH-1000XM5 블루투스 헤드폰", "description": "업계 최고의 노이즈 캔슬링 무선 헤드폰", "price": 429000, "category": "헤드폰" } } ] }}took: 5는 5밀리초 만에 검색이 완료되었음을 의미한다.
Elasticsearch vs RDBMS 비교
용어 매핑
| RDBMS | Elasticsearch | 설명 |
|---|---|---|
| Database | Index | 데이터 저장 공간 |
| Table | Type (deprecated) | 7.x 이후 하나의 Index = 하나의 Type |
| Row | Document | 하나의 데이터 레코드 |
| Column | Field | 데이터 속성 |
| Schema | Mapping | 필드 타입 정의 |
| SQL | Query DSL | 쿼리 언어 |
언제 무엇을 써야 하나?
| 사용 사례 | RDBMS | Elasticsearch |
|---|---|---|
| 트랜잭션 (ACID) | ✅ 적합 | ❌ 부적합 |
| 복잡한 JOIN | ✅ 적합 | ❌ 부적합 |
| 실시간 분석/집계 | ⚠️ 제한적 | ✅ 적합 |
| 전문 검색 | ⚠️ 제한적 | ✅ 적합 |
| 로그 분석 | ❌ 부적합 | ✅ 적합 |
| 대시보드 | ⚠️ 제한적 | ✅ 적합 |
결론: Elasticsearch는 RDBMS를 대체하는 것이 아니라 보완하는 것이다.
일반적인 아키텍처
┌─────────────┐ Write ┌──────────────┐│ Application│──────────────▶│ PostgreSQL │ (Source of Truth)└─────────────┘ └──────────────┘ │ │ │ Search │ Sync (CDC/Batch) ▼ ▼┌─────────────┐ ┌──────────────┐│ Client │◀──────────────│ Elasticsearch│ (Search Index)└─────────────┘ Results └──────────────┘- PostgreSQL: 원본 데이터, 트랜잭션 처리
- Elasticsearch: 검색 전용 인덱스
- 동기화: CDC(Change Data Capture) 또는 배치 처리로 데이터 동기화
도입 전 체크리스트
Elasticsearch 도입 전 확인해야 할 사항들:
기술적 요구사항
- 데이터 규모: 10만 건 이상의 검색 대상 데이터
- 검색 복잡도: 단순 키워드 매칭 이상의 요구사항
- 응답 시간: 100ms 이하의 검색 응답 필요
- 동시 요청: 초당 100 이상의 검색 요청
운영 고려사항
- 인프라: 최소 3노드 클러스터 권장 (고가용성)
- 메모리: 노드당 최소 4GB, 권장 16GB+ 힙
- 스토리지: SSD 필수, 원본 데이터의 1.5~2배 용량
- 모니터링: Prometheus + Grafana 또는 Elastic Stack
팀 역량
- 학습 곡선: Query DSL, 매핑, 클러스터 관리 학습 필요
- 운영 경험: JVM 튜닝, 샤드 관리 경험
- 장애 대응: 클러스터 복구, 데이터 재색인 절차
OpenSearch와의 관계
2021년 AWS는 Elasticsearch 7.10을 포크하여 OpenSearch를 출시했다. 라이선스 변경(SSPL)에 대한 대응이었다.
공통점
- 동일한 핵심 엔진 (Lucene 기반)
- Query DSL 호환 (대부분)
- REST API 호환
차이점
| 구분 | Elasticsearch | OpenSearch |
|---|---|---|
| 라이선스 | SSPL / Elastic License | Apache 2.0 |
| 관리 주체 | Elastic | AWS + 커뮤니티 |
| 클라우드 | Elastic Cloud | AWS OpenSearch Service |
| 최신 기능 | Elasticsearch 우선 | 포크 후 별도 개발 |
어떤 것을 선택해야 하나?
- AWS 환경: OpenSearch Service 권장
- Elastic 에코시스템 필요: Elasticsearch (Kibana, APM 등)
- 온프레미스/오픈소스 선호: OpenSearch
이 시리즈에서는 Elasticsearch를 기준으로 설명하되, 중요한 차이점은 별도로 표기한다.
마무리
이 글에서 다룬 내용을 정리하면:
- RDBMS LIKE 검색의 한계: Full Table Scan으로 인한 성능 저하
- 역인덱스의 원리: 단어 → 문서 매핑으로 O(1) 검색
- Elasticsearch 특징: 분산, 실시간, RESTful 검색 엔진
- 사용 시점: 전문 검색, 로그 분석, 대시보드 등
- 아키텍처: RDBMS 보완, 검색 전용 인덱스로 활용
다음 글에서는 Elasticsearch의 클러스터, 노드, 샤드 아키텍처를 자세히 알아본다. 데이터가 어떻게 분산 저장되고, 고가용성은 어떻게 보장되는지 이해하면 프로덕션 운영에 큰 도움이 된다.